


Слова и дело: искусственный интеллект поможет изучить древнерусские рукописи
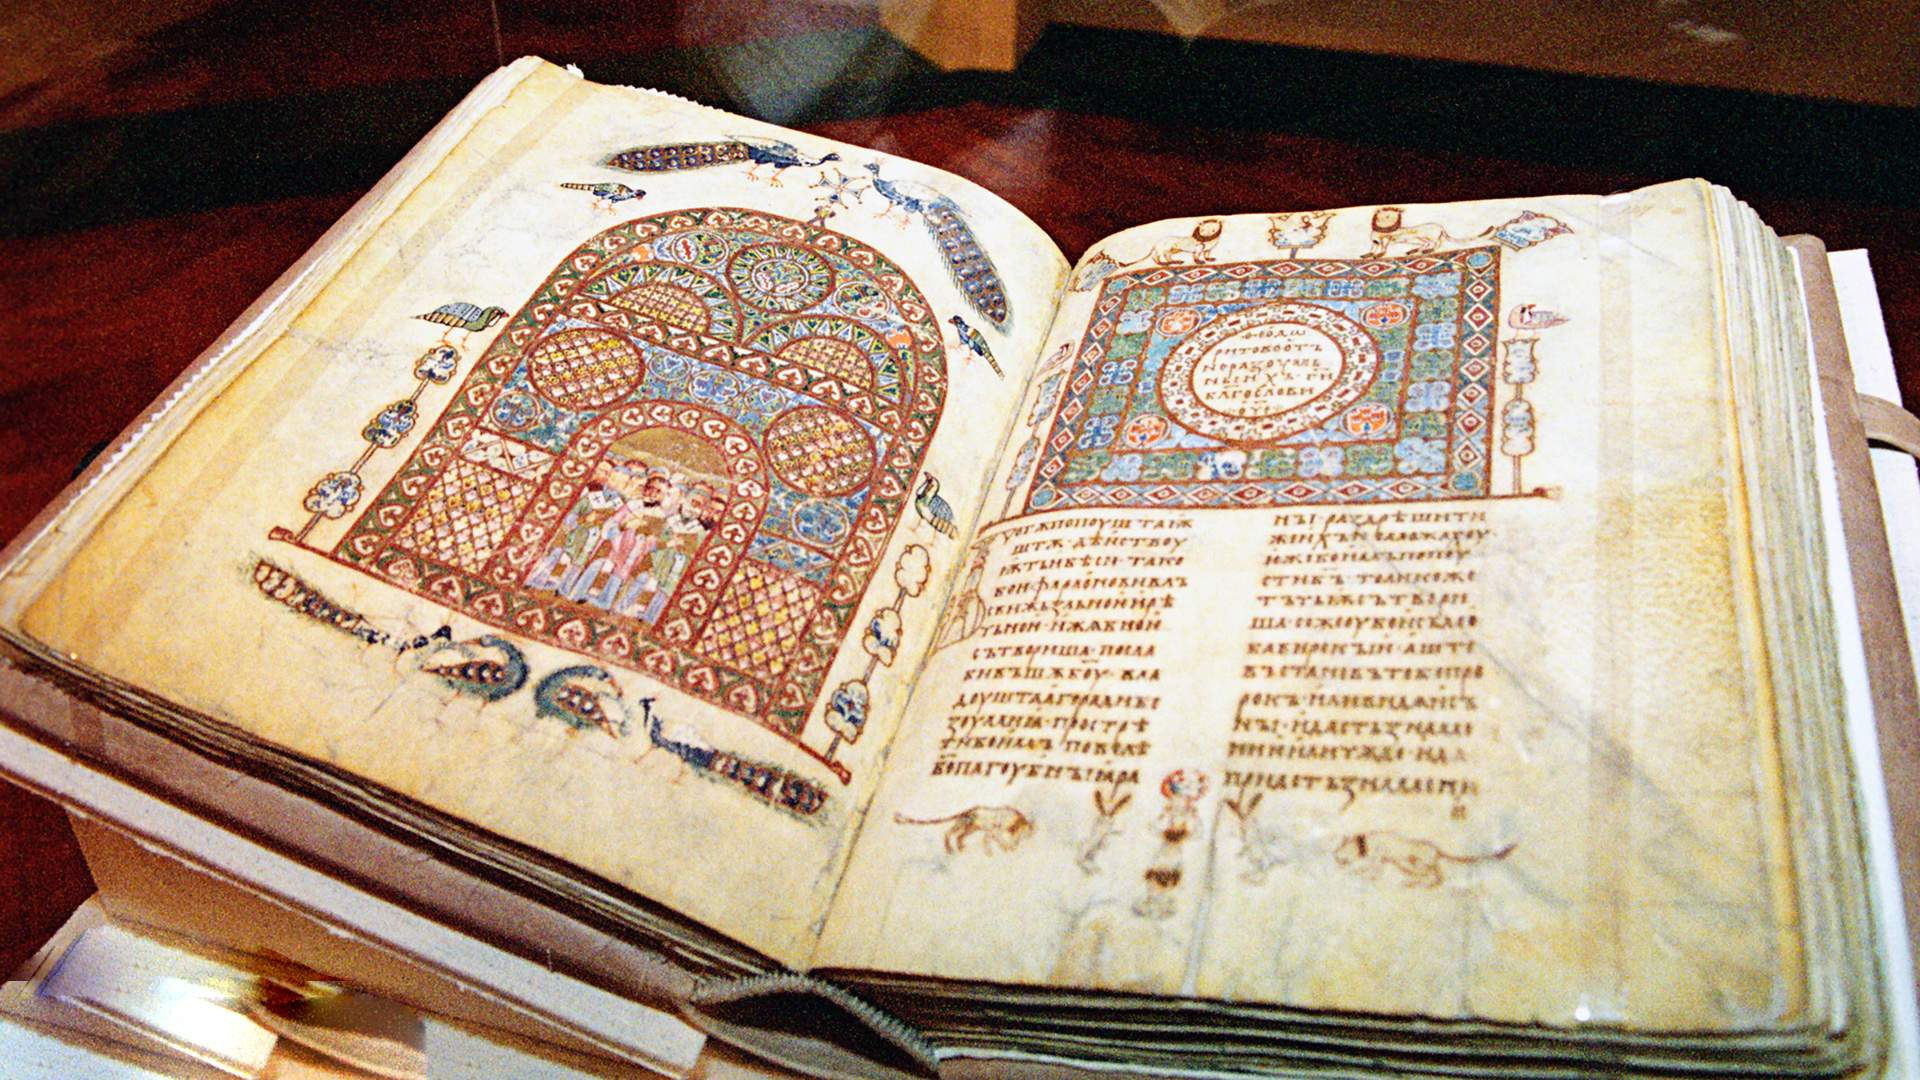
Ученые разработали поисковую систему по рукописям XI–XVIII веков, основанную на алгоритмах искусственного интеллекта. Она способна распознавать документы допечатного периода и представлять выборку данных под конкретный запрос. На начальной стадии проекта поиск выполняется по оцифрованным рукописям миней — церковных книг с праздничными службами — которые хранятся в российских библиотеках и музеях. В перспективе в базу будут добавлены летописи, литературные произведения, служебные и технические документы Древней Руси.
Как искать информацию в древних рукописях
Российские лингвисты и кибернетики научили искусственный интеллект производить поиск по древнерусским текстам — книгам, написанным от руки на старославянском языке в период с XI по XVIII века. В проекте приняли участие специалисты из НИЯУ МИФИ и Института русского языка имени В.В. Виноградова.

По словам ученых, система представляет собой комплекс программ на основе нейросетей и других алгоритмов обработки больших данных. С ее помощью исследователи смогут распознавать рукописи и производить из них выборку по различным параметрам. Например, запросы можно конкретизировать по историческим эпохам, отдельным темам, книгам или их фрагментам. Кроме слов, программа позволяет формулировать требования длинными фразами.

Также можно указывать, в какой части рукописи следует производить выборку. Например, в основном тексте или в вязи — декоративном письме, которым оформляли заголовки и орнаменты и в которых начертание символов значительно отличается от обычного.
— Для работы с текстами создан сетевой ресурс «Рукописное наследие Древней Руси», оснащенный специальным интерфейсом. Процедура запросов в нем обрабатывается как в обычном интернет-поисковике. Кроме того, разработана онлайн-клавиатура, которая дает возможность набирать слова старославянскими символами. Поиск выполняется по оцифрованным текстам из различных хранилищ — Российской государственной библиотеки, Исторического музея и региональных учреждений культуры, — рассказал «Известиям» руководитель проекта, доцент кафедры кибернетики НИЯУ МИФИ Дмитрий Демидов.
Как изучение языка поможет понять историю и культуру
Ученый пояснил, что сейчас поисковая база включает в себя 245 миней. Так называют богослужебные книги, которые содержат службы церковных праздников в течение года. Обычно в каждой церкви имеется по одной такой книге на каждый месяц и несколько «годовых», посвященных наиболее значимым событиям и святым. В среднем такие книги состоят из 500 страниц.

Ведущий научный сотрудник ИРЯ РАН и НИЯУ МИФИ Александра Плетнева
— Минеи — самый распространенный вид древнерусских рукописей. В них повторяются одни и те же священные сюжеты, однако изучение и сравнение этих похожих текстов даст возможность понять, где, когда и при каких обстоятельствах происходили изменения в нашем языке, культуре и мировосприятии. Например, можно увидеть, как по-разному трактуется одна и та же история в разные эпохи. Или как изменяется значение слов со временем, — со своей стороны пояснила ведущий научный сотрудник ИРЯ РАН и НИЯУ МИФИ Александра Плетнева.
Она подчеркнула, что изменения, которые происходят в обществе, отражаются и в языке. И исследование богослужебных текстов на обширном материале дает возможность проследить многие исторические и культурные процессы на протяжении веков.
Преимущество алгоритмов ИИ, по мнению ученого, заключается в том, что они позволяют работать не с отдельными произведениями, как это делали филологи прежде, а охватить весь оцифрованный объем отечественной богослужебной, художественной и технической литературы допечатного периода.

Как нейросети распознают рукописи
По словам ученых, обработка древних текстов состоит из трех основных процессов. Сначала программа сегментирует страницу, вычленяя отдельные элементы и символы. Затем происходит их классификация и обучение нейросети анализировать эти объекты. Однако при этом возникает ряд трудностей. Часть из них связана с различием в начертании одинаковых знаков в разных рукописях, а также с особенностями морфологии и синтаксиса старославянского языка.
— Бывает, что доходит до 150 вариантов одной буквы, ведь несмотря на принятые каноны и шрифты (устав и полуустав), каждый писец вносил в их написание свои стилистические особенности. Кроме того, старинный алфавит включал 46 букв вместо 33 современных. И в целом древнерусское письмо характеризуется наличием большого количества сокращений, надстрочных элементов, отсутствием отступов между словами и знаков препинания, — объяснил Дмитрий Демидов.

Доцент кафедры кибернетики НИЯУ МИФИ Дмитрий Демидов
По его словам, в настоящее время ученые наращивают точность распознавания рукописей, что включает в себя снижение ошибок сегментации и классификации. Поэтому важно, что оцифрованные древние документы размещены на доступном интернет-ресурсе. Это дает возможность исследователям проверить корректность распознавания и в случае ошибки сообщить об этом разработчикам.
— Применением программных алгоритмов для исследования текстов в нашей стране занимаются несколько научных групп. В пример можно привести крупный проект по распознаванию рукописей политических деятелей России XIX — начала ХХ веков. Разработки отечественных ученых в этом направлении сопоставимы с зарубежными или превосходят их, — рассказал «Известиям» заведующий кафедрой социальной и экономической истории России Института общественных наук (ИОН) Президентской академии Роман Кончаков.
Он отметил, что инструменты искусственного интеллекта сделают доступными сокровища архивов и библиотек широкому кругу граждан. В перспективе разработка будет полезна для анализа документов приказного делопроизводства, данных внутренних таможен, а также других прикладных исследований.
Вместе с тем решать такую амбициозную задачу, как исследование древнерусских летописей, необходимо с привлечением широкого круга экспертов — как программистов и специалистов в сфере машинного обучения, так и филологов, историков и других представителей гуманитарных наук, считает директор Исследовательского центра Искусственного интеллекта ИОН Сергей Боловцов.

— Славянские минеи как минимум дважды подверглись масштабному редактированию — в связи с распространением Иерусалимского устава в XIV веке и в результате Никоновской книжной справы в XVII веке. Если можно проследить по рукописным памятникам эволюцию языка и отделить написанное древними авторами от поздних цитат, это позволит глубже понять отечественную историю, — полагает доцент кафедры русского языка и лингвокультурологии Института русского языка (ИРЯ) Российского университета Дружбы народов имени П. Лумумбы Алексей Овчаренко.
При этом он напомнил, что алгоритмы машинного обучения основаны на вероятностях. Поэтому распознавание символов старославянского языка на начальном этапе должно проверяться экспертами. А в дальнейшем искусственному интеллекту можно предоставить большую свободу.
Трудной задачей для нейросетей будут орнаментальные элементы. Например, вязь, с ее украшениями и витиеватостями, вероятно, еще долго будет доступна только разуму с творческими способностями, заключила заведующая кафедрой русского языка № 4 ИРЯ РУДН Юлия Калинина.
